음성 인식만
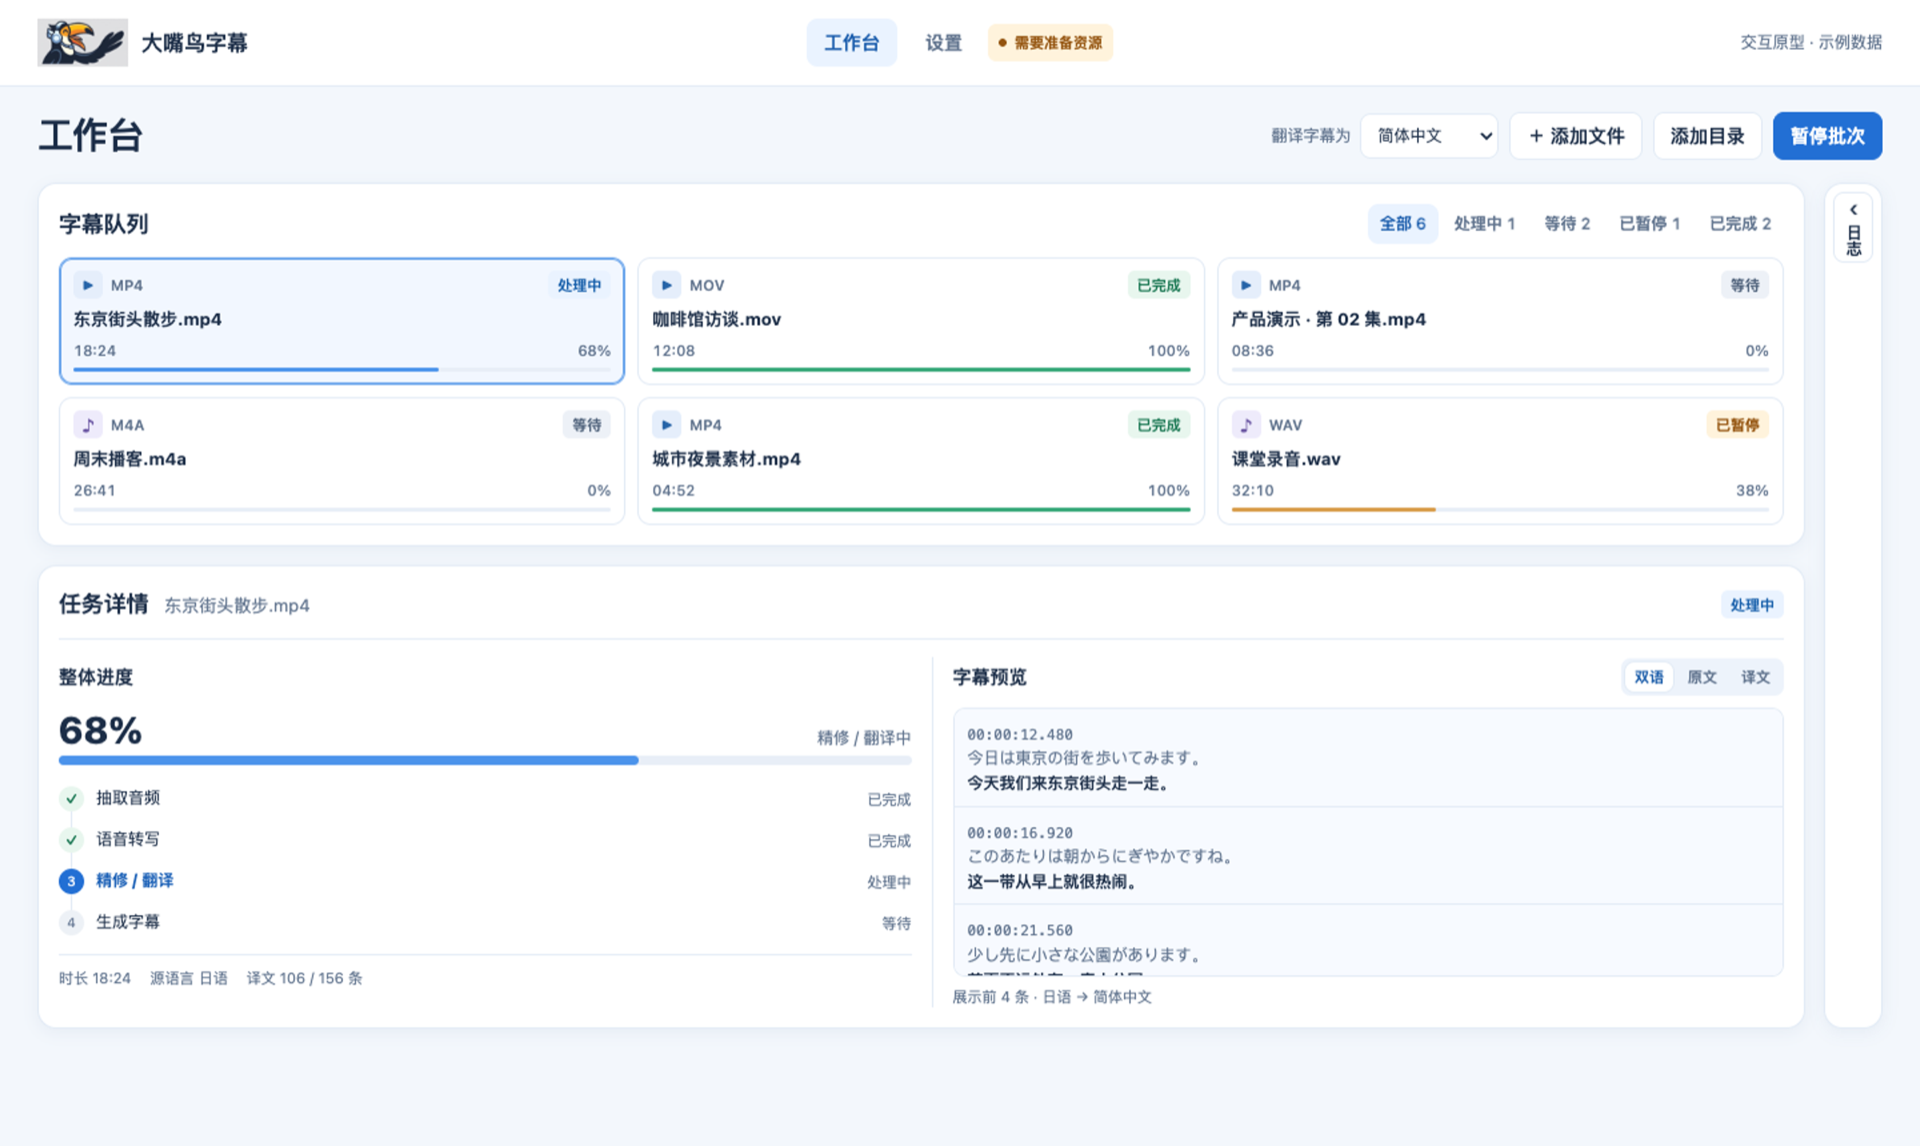
Whisper로 음성을 인식해 원어 텍스트와 타임코드가 담긴 SRT를 만듭니다.
회의, 인터뷰, 강의에 적합Whisper로 음성을 인식해 원어 텍스트와 타임코드가 담긴 SRT를 만듭니다.
회의, 인터뷰, 강의에 적합선택한 모델로 표현과 문장 부호를 다듬고 언어와 타임라인을 유지합니다.
구어체 녹음을 정리할 때대상 언어를 선택하고 두 자막을 비교하세요. 원어 자막도 함께 내보낼 수 있습니다.
외국어 영상과 이중 언어 자막에작업 공간
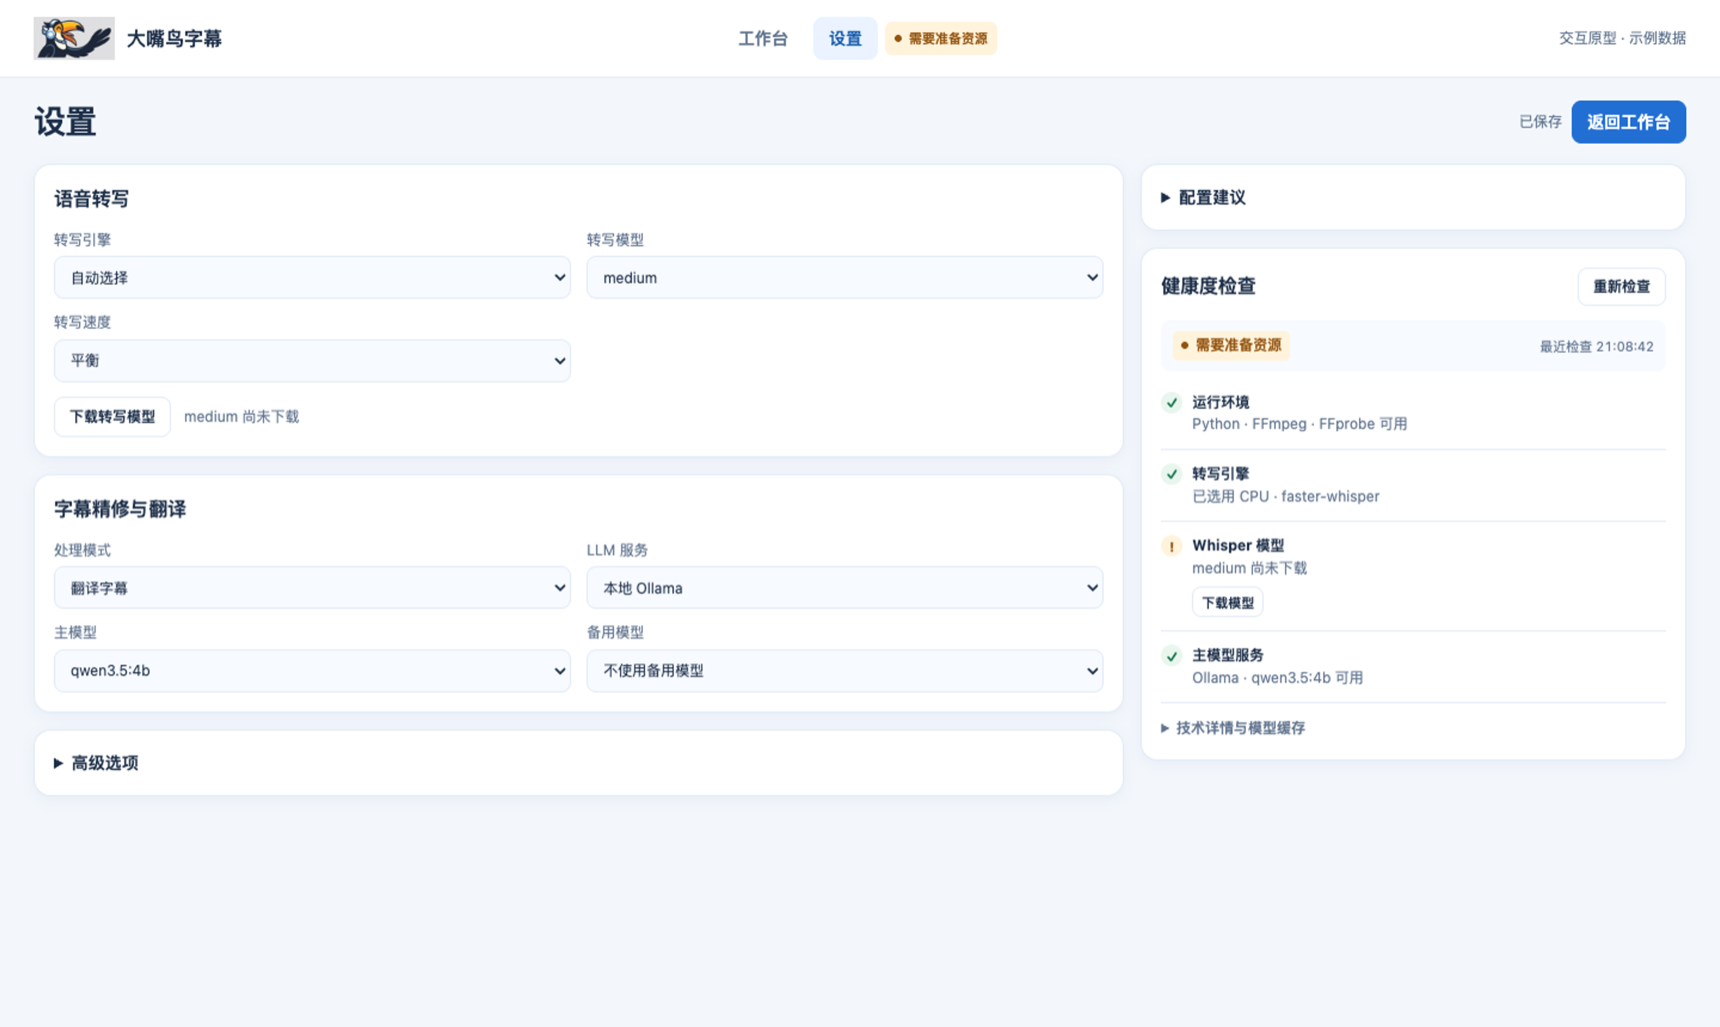
모델과 상태 점검
앱 설치 패키지에 대규모 언어 모델은 포함되지 않습니다. 자막을 다듬거나 번역하려면 Ollama를 설치해 모델을 다운로드하거나 OpenAI 호환 클라우드 서비스의 API 키를 직접 준비하세요.
음성 인식에만 사용하는 Whisper 가중치는 별도로 다운로드하며 Ollama나 API 키는 필요하지 않습니다.
설정에서 실행 환경, 엔진, 가중치와 모델을 점검합니다.
설정 방법 보기 ↗