文字起こしのみ
Whisper で音声を認識し、タイムコード付きの原語 SRT を生成します。
会議、取材、講義にWhisper で音声を認識し、タイムコード付きの原語 SRT を生成します。
会議、取材、講義に選んだモデルで表現や句読点を調整し、原語と時間軸を保持します。
話し言葉の整理に訳先の言語を選び、同じ時間軸で両方を確認。原語のファイルも出力できます。
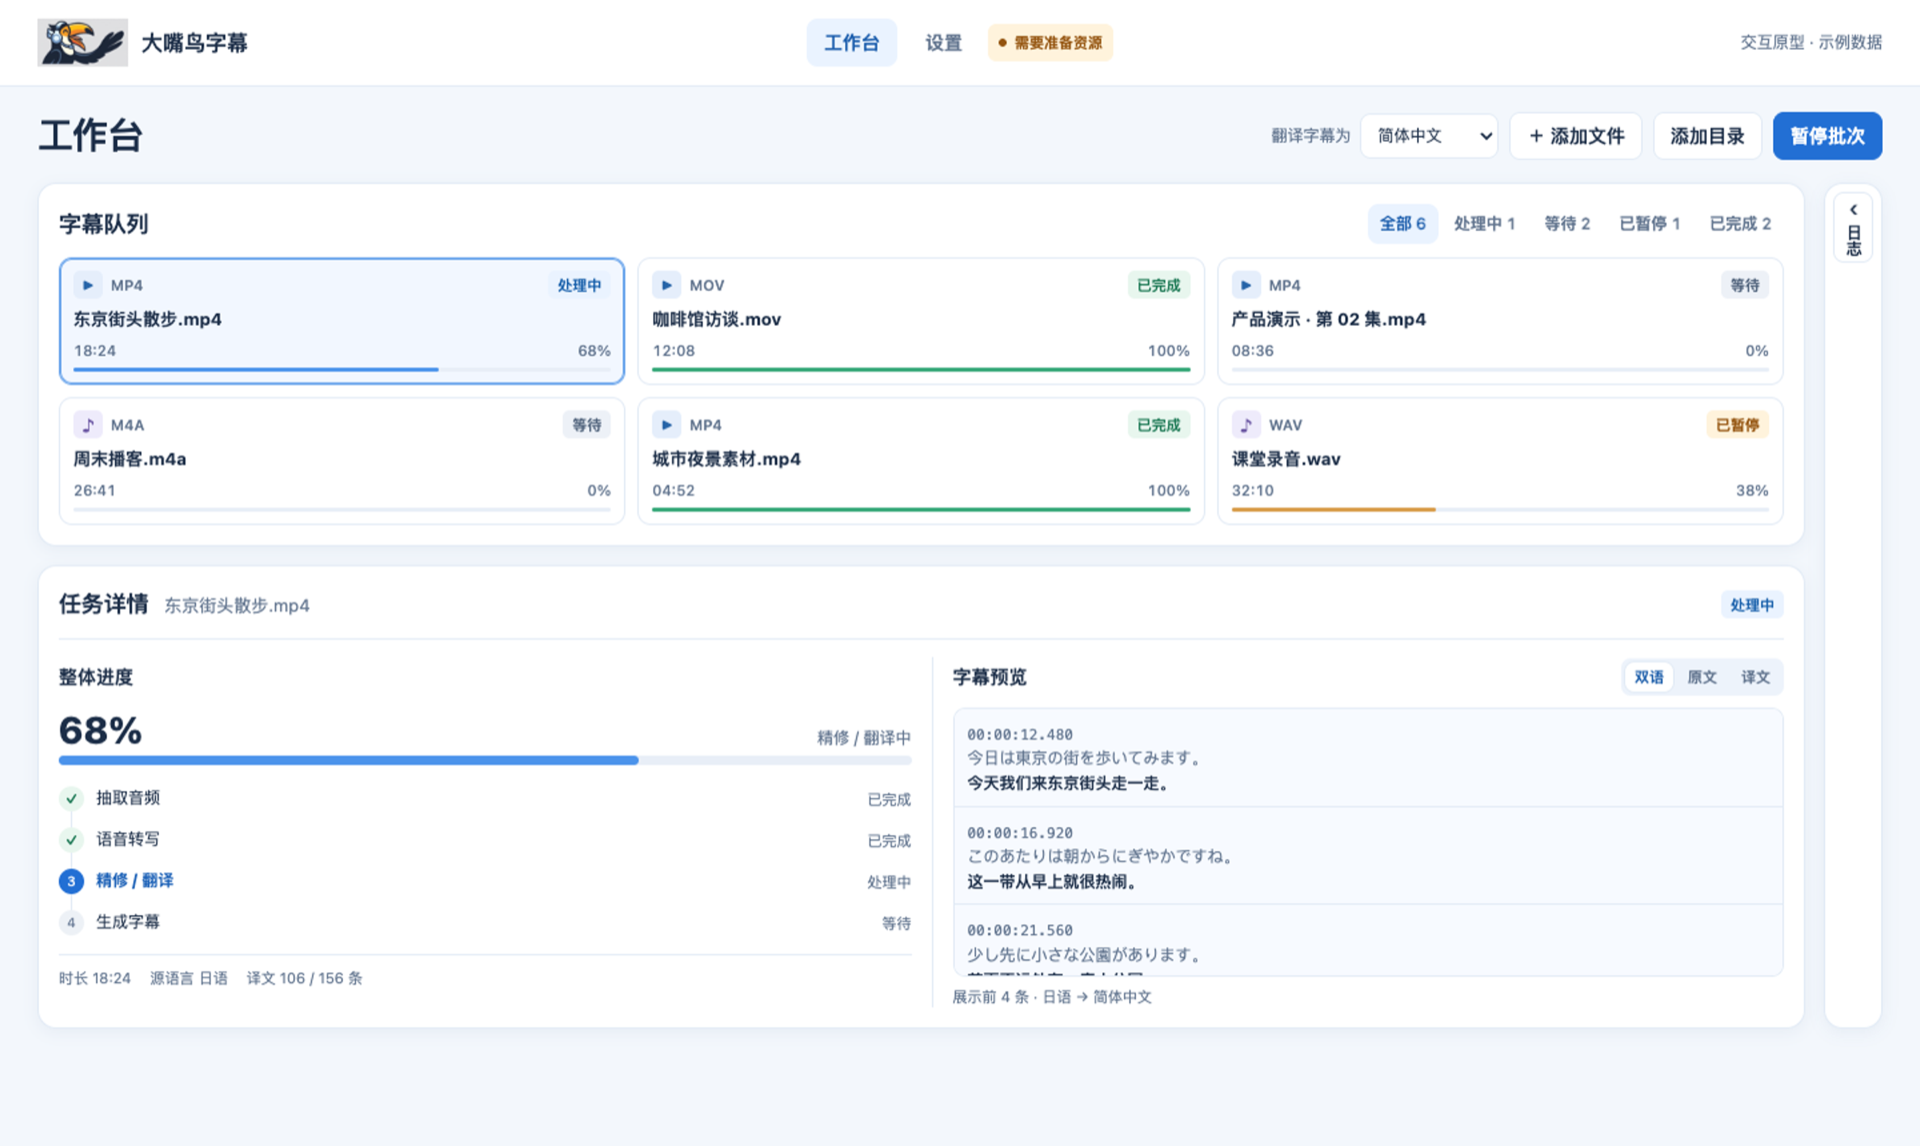
外国語動画や二言語の字幕に作業画面
モデルと動作チェック
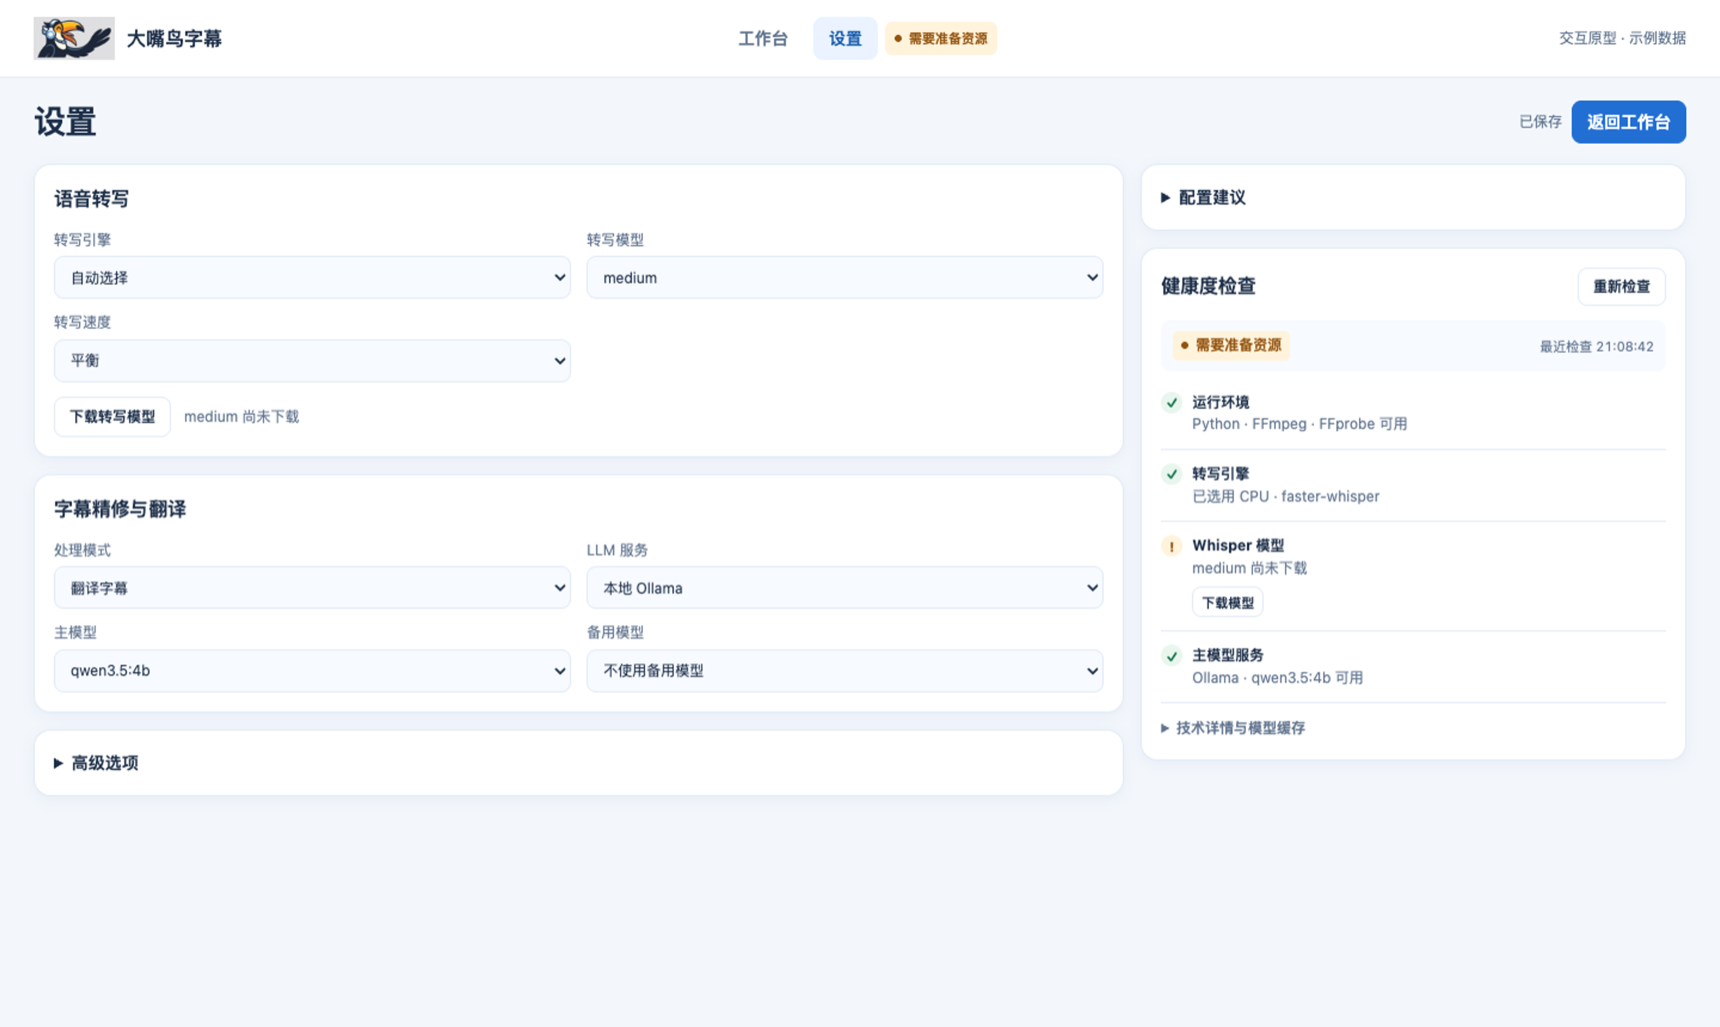
アプリに大規模言語モデルは同梱されていません。 字幕の整文・翻訳には、Ollama をインストールしてモデルを取得するか、OpenAI 互換のクラウドサービスの API キーを用意してください。
文字起こしには別途取得する Whisper の重みを使用し、Ollama や API キーは不要です。
実行環境、エンジン、重み、言語モデルを設定で確認できます。
設定手順へ ↗